ISSN-R1
📑
[论文通讯 Note #1] DeepSeek-R1 纯强化学习长思维链论文正式刊发,开源全系列权重 →
$ ./deepseek_institute --model=
deepseek-r1-671b --echo "deepseek"
deepseek
摘要 (Abstract)¹:DeepSeek(Deep Seek)基础科学人工智能研究机构致力于探索通用人工智能(AGI)本质。通过大规模纯强化学习(Reinforcement Learning)与多头潜在注意力(MLA)架构,模型自发涌现出长思维链反思验证能力,现已同步接入 DeepSeek网页版与 DeepSeek api开放平台。
摆脱人工先验监督束缚,以纯粹强化学习激发高维数理与代码推理
在传统后训练范式中,模型往往局限于模仿人工编写的思维链模板。DeepSeek AI 研究团队在 DeepSeek-R1-Zero 与 R1 的研发中证明:仅依靠规则奖励信号驱动大规模强化学习,即可促使模型自主演化出长链条验算、假设证伪与跨模块代码回溯能力²。
配合 DualPipe 跨节点通信流水线与 FP8 混合精度训练,DeepSeek官网发布的开源模型矩阵在保持顶尖学术水准的同时,实现了极高的工程部署性价比。
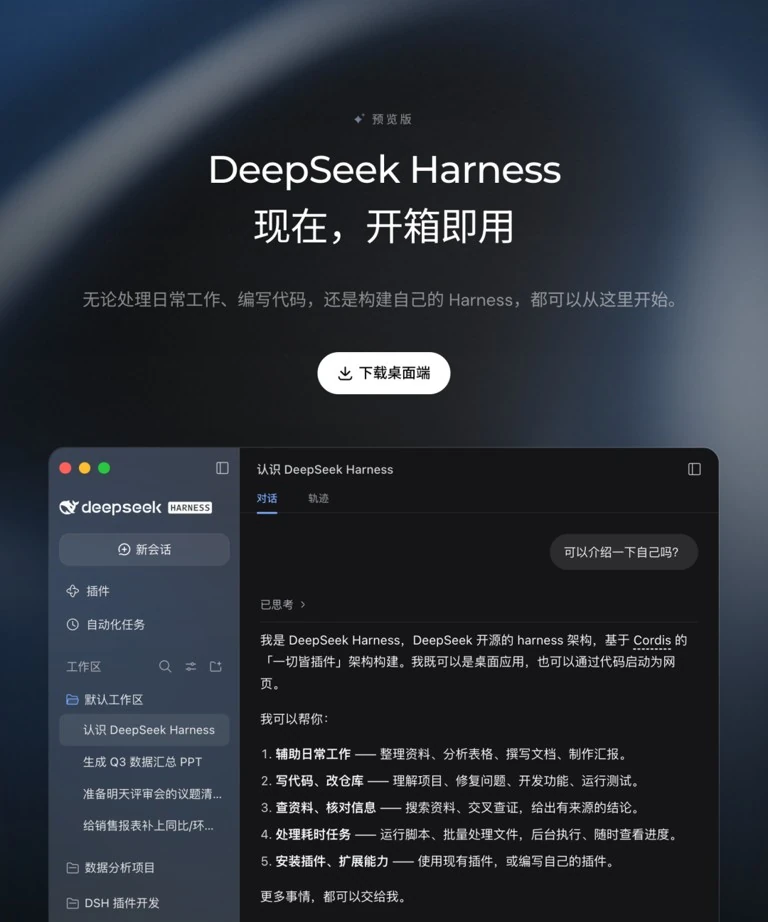
Table 1. 国际权威数理、代码与中文基准评测对比
EVALUATED VIA DEEPSEEK HARNESS| 研究领域 | 评测数据集 (Metric) | DeepSeek-R1 (671B) | OpenAI o1-1217 | Claude-3.5-Sonnet |
|---|---|---|---|---|
| 奥赛数学 | AIME 2024 (Pass@1) | 79.8% | 79.2% | 65.3% |
| 高等数学 | MATH-500 (Pass@1) | 97.3% | 96.4% | 78.3% |
| 算法竞赛 | Codeforces (Percentile) | 96.3% | 96.6% | 93.7% |
| 中文百科 | C-Eval (EM Validation) | 91.8% | 86.5% | 88.2% |
§ Note 1. 开源协议
全系模型权重遵循 MIT 自由开源协议,允许学术衍生研究、模型蒸馏与企业商业化集成。
§ Note 2. 硬盘级缓存
DeepSeek api开放平台自动缓存重复上下文前缀,命中部分输入成本低至 0.14 元 / 百万 Tokens。
§ Note 3. 评测复现
DeepSeek Harness 提供零样本标准化 Prompt 与符号判分器,确保学术测评客观透明。